Olá amigos!
Hoje iremos abordar as questões de fluência de dados para analista da Receita Federal. Vem comigo!
Resolução:
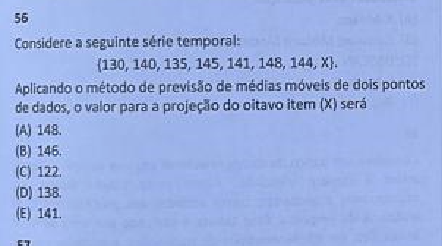
A previsão da média móvel utiliza-se dos últimos valores como valor de previsibilidade, veja que a questão pede por dois ponto, ou seja, o cálculo deve ser feito com os dois últimos valores, sendo assim:
(148+144)/2 = 146
Resposta correta, alternativa B
Resolução:
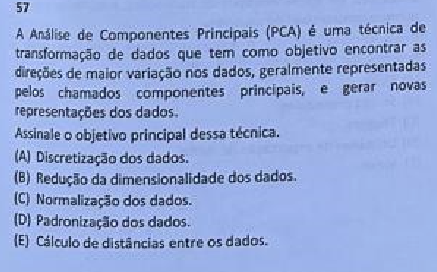
Vamos entender o que é PCA.
Esta técnica tem como finalidade projetar os dados em um vetor que minimize a variância, diminuindo a quantidade de variáveis independentes.
Veja que essa finalidade do PCA está diretamente ligado a redução da dimensionalidade dos dados.
Resposta correta, alternativa B
Resolução:
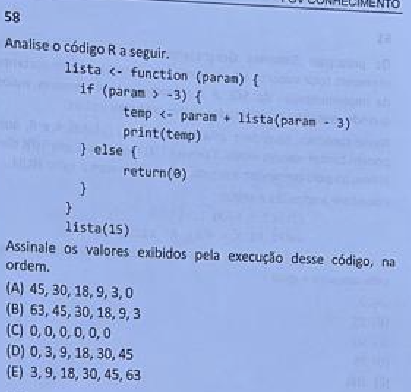
Temos uma questão de recursividade aqui.
Nesta função temos que se a variável param for maior que -3, sendo maior que -3 então a variável temp recebe o valor da variável param, além da função lista, recebendo o valor de param -3.
Como param = 15, temos:
15>-3
temp <- 15+lista(15-3) = 15+lista (12)
Agora com o valor de lista(12) temos:
12+lista(9)
Nessa continuidade temos:
9+lista(6)
6+lista(3)
3+lista(0)
0+lista(-3)
Sendo assim, os valores impressos são:
lista(0) = 0+lista(-3) =0
lista(3) = 3+lista(0) = 3+ 0 =3
lista(6) = 6+lista(3) = 6 +3 = 9
lista(9) = 9 +lista(3) = 9 + 9 = 18
lista(12) = 12 + lista(9) = 12 + 18 = 30
lista(15) = 15 + lista(12) = 15+30 = 45
Resposta correta, alternativa D
Resolução:
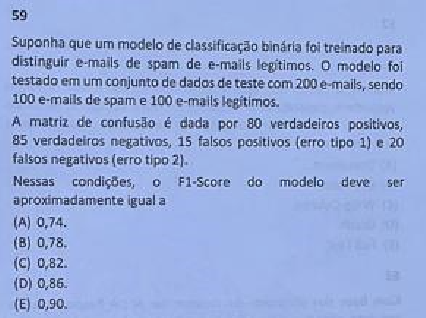
Antes de calcular o F1-Score, primeiramente devemos ter os valores de recall e precisão.
precisão = Verdadeiros positivos/(Verdadeiros positivos + Falsos positivos) = 80/(80 + 15) = 80/95 = 0,84
recall = Verdadeiros positivos/(Verdadeiros positivos + Falsos negativos) = 80/(80 + 20) = 0,8
Agora que temos a precisão e o recall, F1-score é:
F1-score = 2*precisão*recall/(precisão +recall) = 2*0,84*0,8/(0,84+0,8) = 0,82
Resposta certa, alternativa C
Resolução:
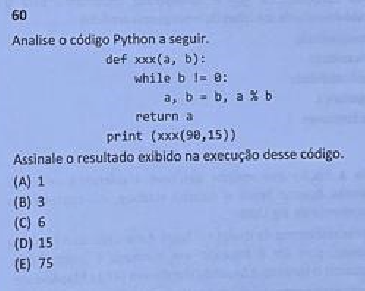
Vamos nos atentar ao while. Veja que a função estará em loop até b = 0, e veja que o valor de entrada de b é 15, sendo assim a primeira iteração será:
a = b = 15
b = 90%15 = 0 (Isso porque a sobre da divisão entre 90 e 10 é 0)
Veja que agora B é igual a 0, portanto não haverá uma nova iteração, sendo assim, a continua valendo 15.
Resposta correta, alternativa D
Resolução:
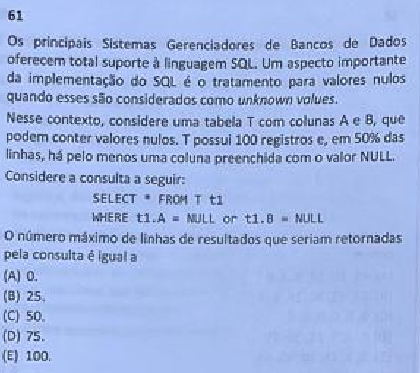
Sugestão de recurso ao final do artigo
Resolução:
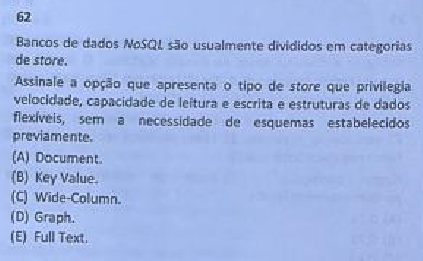
Acredito que o melhor score para este tipo de necessidade seja o score Key Value (Chave-valor) já que este representa uma grande velocidade de busca, além de facilidade para leitura e escrita dos dados.
Resposta correta, alternativa B
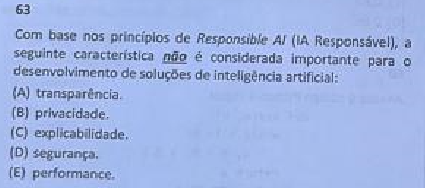
Resolução:
Os princípios são:
Viés, transparência, explicabilidade, interpretabilidade, robustez, segurança e privacidade.
Veja que apenas performance não está incluso.
Resposta correta, alternativa E
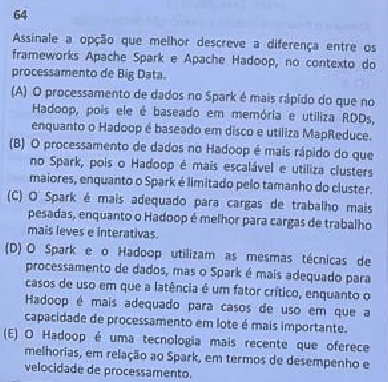
Resolução:
O Spark aparesenta uma velocidade maior que no Hadoop, isso se dá devido ao Spark utilizar a memória ao invés de disco rígidos com o Hadoop.
Resposta correta, alternativa A
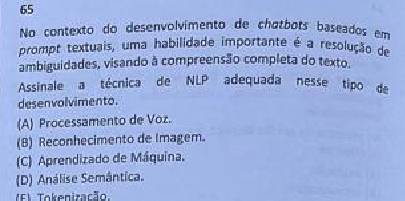
Resolução:
Neste caso é necessário a compreensão do entendimento da frase; isso se dá pela Análise Semântica.
Resposta correta, alternativa D
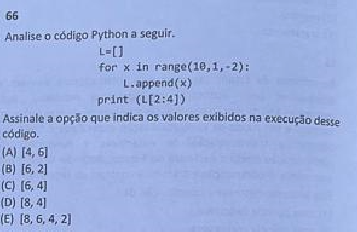
Resolução:
Primeiramente vamos ver a lista L depois de passar pelo loop for
L = [10,8,6,4,2]
Agora queremos os valores na posição 2 e 3, veja:
L[2] = 6 e L[3] = 4
L[2:4] = [6,4]
Resposta correta, alternativa C
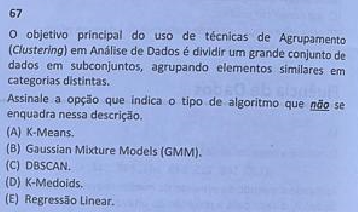
Resolução:
Existem três subáreas de Machine Learning: classificação, regressão e clusterização.
Veja que das opções dadas, regressão linear é uma regressão e não uma clusterização.
Alternativa correta E
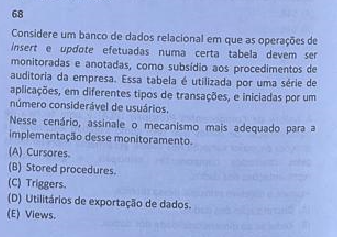
Resolução:
Sugestão de recurso ao final do artigo
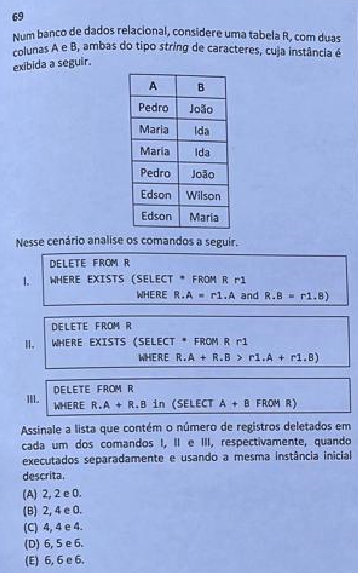
Resolução:
Sugestão de recurso ao final do artigo
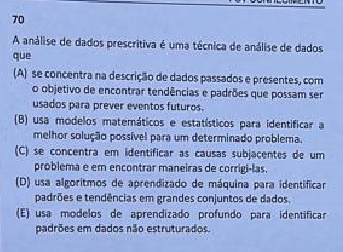
Resolução:
A análise prescritiva vai se utilizar do comportamento utilizando ferramentas matemáticas e estatísticas para identificar a melhor solução para o problema
Resposta correta, alternativa B
*SUGESTÃO DE RECURSO*
NÃO HÁ MODELO RELACIONAL NO EDITAL!
A banco adicionou SQL e banco de dados relacionais linkado com Principais SGBDs.
Embora SGBDs utilizem sim a linguagem SQL não é possível inferir cobranças em relação a tal linguagem. Considerando editais anteriores da FGV (SEFAZ-MG/2022 e SEFAZ-MT/2023) em ambos os editais cobra a linguagem SQL e os principais SGBDs; pois então, não faz sentido trazer este tipo de exercício quando a banca não deixa explicito SQL e modelo relacional.
